监控
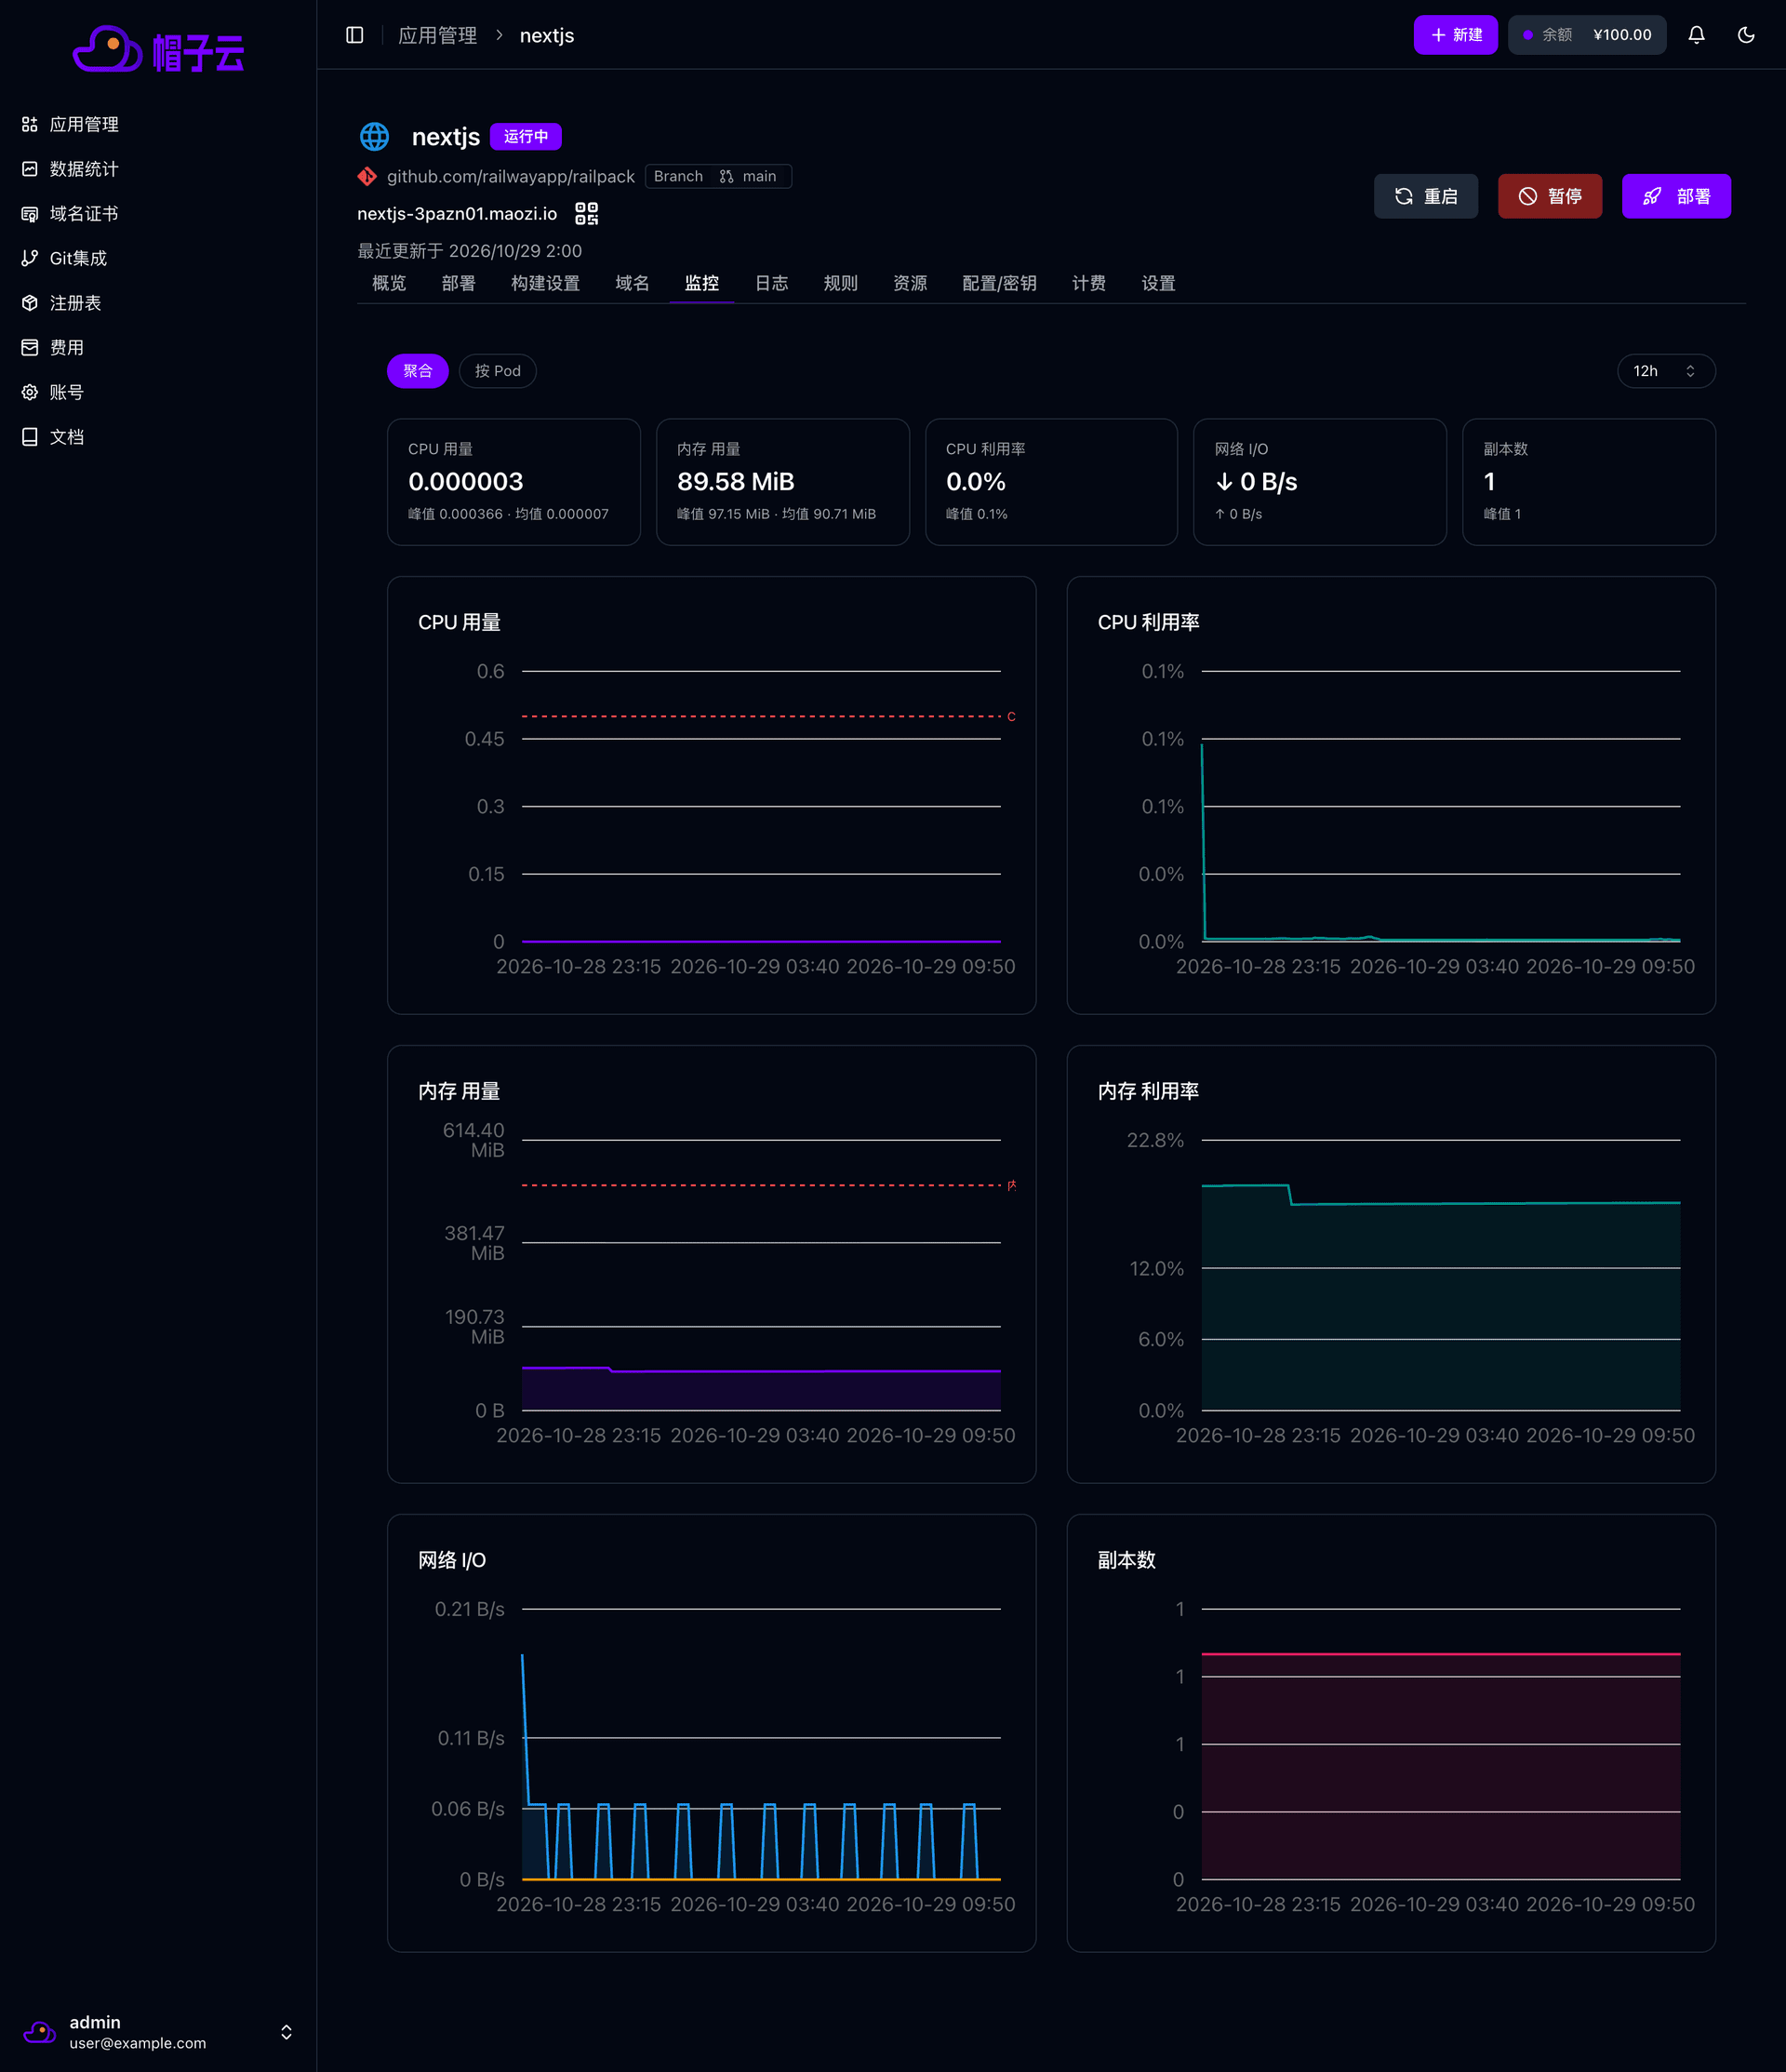
监控 标签页展示 Web 应用、PostgreSQL 和 Redis 的资源使用情况,用来判断规格是否合适、定位性能问题。
查看方式
- 聚合 / 按 Pod:聚合 把所有实例合成一条曲线;按 Pod 为每个实例单独画一条 CPU 和内存曲线,便于找出异常实例。
- 时间范围:右上角可选 1h、6h、12h、24h、7d、30d,默认 12h。
汇总卡片
| 卡片 | 含义 |
|---|---|
| CPU 用量 | 当前值,附峰值和均值,单位为核 |
| 内存 用量 | 当前值,附峰值和均值 |
| CPU 利用率 | 用量占 CPU 限额的比例,附峰值 |
| 网络 I/O | 当前接收(↓)和发送(↑)速率 |
| 副本数 | 当前运行的实例数,附峰值 |
图表
| 图表 | 说明 |
|---|---|
| CPU 用量 | 红色虚线为 CPU 限额,即规格的 CPU 上限 |
| CPU 利用率 | CPU 用量 ÷ 限额 |
| 内存 用量 | 红色虚线为 内存 限额 |
| 内存 利用率 | 内存用量 ÷ 限额 |
| 网络 I/O | 接收 和 发送 两条曲线 |
| 副本数 | 阶梯图,显示实例数变化 |
如何解读
- CPU 长时间贴近限额:请求会变慢,建议在 资源 中升级规格。
- 内存持续接近限额:超过限额时容器会被系统终止并重启,概览页的 重启次数 会增加。请升级规格或排查内存泄漏。
- 利用率长期很低:可以降级到更小的规格节省费用。
更新于